新手问题 Sidekiq 如何 load balance queue 和 worker
leijun · 2019年03月22日 · 最后由 leijun 回复于 2019年03月29日 · 1882 次阅读

大家好,我还是新手,来询问一个关于 sidekiq 和 redis 相关的问题 我现在遇到一个难题,现在的项目做公司分析 平均一个公司分析大概耗时 40 秒,我们把它放在 sidekiq 里 后台执行。 每一个客户可以有很多公司分析. 问题来了,

第一种情况 : 如果客户 A 开启 1000 个公司分析.,另外客户 B 在 1 分钟后开启一个公司分析.,那么我们不想要客户 B 等客户 A 分析完 1000 个公司,然后再分析客户 B 的单个公司分析。 我的提议的使用两个不同的 queue

queues:
  - [normal_client, 20]
  - [urgent_client, 40]

这样客户 B 就能先插队

第二种情况 : 如果客户 A 开启 1000 个公司分析,另外客户 B 在 1 分钟后也开启 100 公司分析,这样我们不希望客户 B 的 100 个公司分析要等到客户 A 的 1000 个公司分析 之后,我希望找一个好的解决方案,比如客户 A 和客户 B 交互分析,客户 A 分析一下,然后客户 B 分析一下,这样大概 客户 A 分析完前 100 个客户的时候,客户 B 的 100 也要分析完毕。 这种情况下该如何设计 queue, 或者如何设计如何把 job 放进 worker 里?或者前面再来一层数据结构?

第三张情况: 我希望每个客户都能有大概时间等待现实,现在不止两个客户,我们假设有很多客户,每个客户有不同数量的公司分析,如果 客户 A 开始分析 , 然后 客户 B C D etc.. 开始 插队。那势必导致客户 A 不断延长他的等待时间,这将造成我们刚开始给客户 A 的等待时间不断延长,这将到底客户 A 的不信任感,客户 A 会想,我可是你们的大金主,什么阿猫阿狗都能插我的队! 那这种情况下该有什么好的解决方案?

这个帖子 我想和大家探讨学习。 先提前感谢大家

也许是我水平有限。但感觉题中的问题不应该是用 Sidekiq 来做的。

你说的「公司分析」,猜测起来应该是一个 Worker Class,毕竟都是「公司分析」,不应该因为完全可变的外部信息客户 ABC 而弄出多种 Worker,否则搞出 AbcWorker、ZzzWorker 了?

另外你 Sidekiq 的配置里的权重数不好,Sidekiq 只关心比例,所以 20-40 应该改成 1-2。

urgent_client 单独启一个 worker 咯

进程调度问题

给每个用户 100 个额度,用完了再分配。

第一个和第二个问题 假设 A 算 1000 个单位,就先让他算 100 个,算完了再分给他 100。这个时候,B 进来了,B 插入 100 个任务,B 就会先算完。

第三个问题 加优先级就可以,爸爸们都放到爸爸队列里,爸爸们有任务,就先算爸爸的。还可以,如果是爸爸,就分配 200 个单位。

还可以从需求上解决,比如算完 1 个就给反馈什么的。

对 yfractal 回复

感觉你抓住了问题的重点。 谢谢,我先去研究一下如何给每个用户额度,和我组的 CTO 讨论讨论该提议能不能管用。然后看看该如何写代码。 你说起进程调度问题,我看到有个 GEM sidekiq scheduling, 不知道这个 gem 有没有用

对 hooopo 回复

谢谢,我会考虑考虑的

对 blacklee 回复

所以客户使用该服务的时候都使用同一个 worker. 一个服务对应一个 worker.

对 leijun 回复

这个 Gem 不是定时任务的 Gem 么

对 leijun 回复

那个 gem 还真没了解过 😅

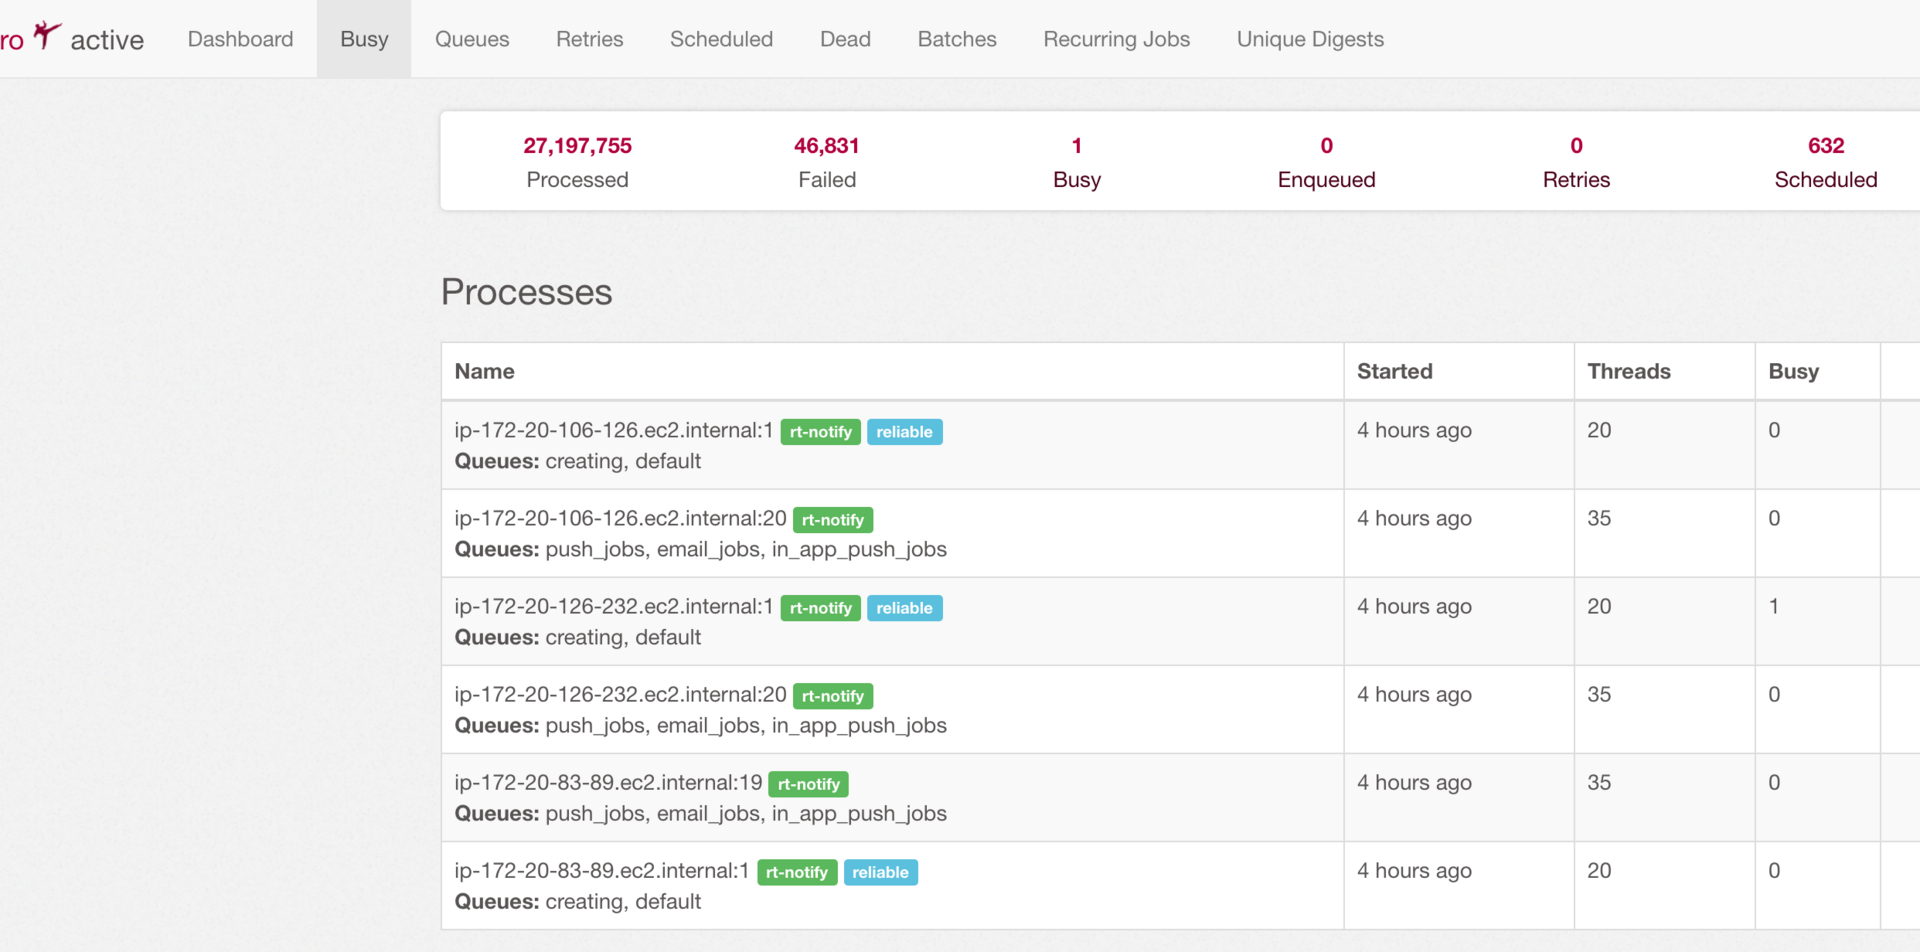
@leijun 多起几个进程,每个进程可以有不同的配置,我们每个 docker container 起两个 sidekiq 进程,
  • 一个进程要保证任务成功用了 sidekiq-pro,
  • 另一个进程只读数据库,不需要写,所以可以不用 sidekiq-pro,崩溃了也无所谓,没用 sidekiq-pro 在 redis 效率上应该会更高一点。

一个进程太多 threads 感觉不是很好,考虑多起几个服务器多几个进程吧。

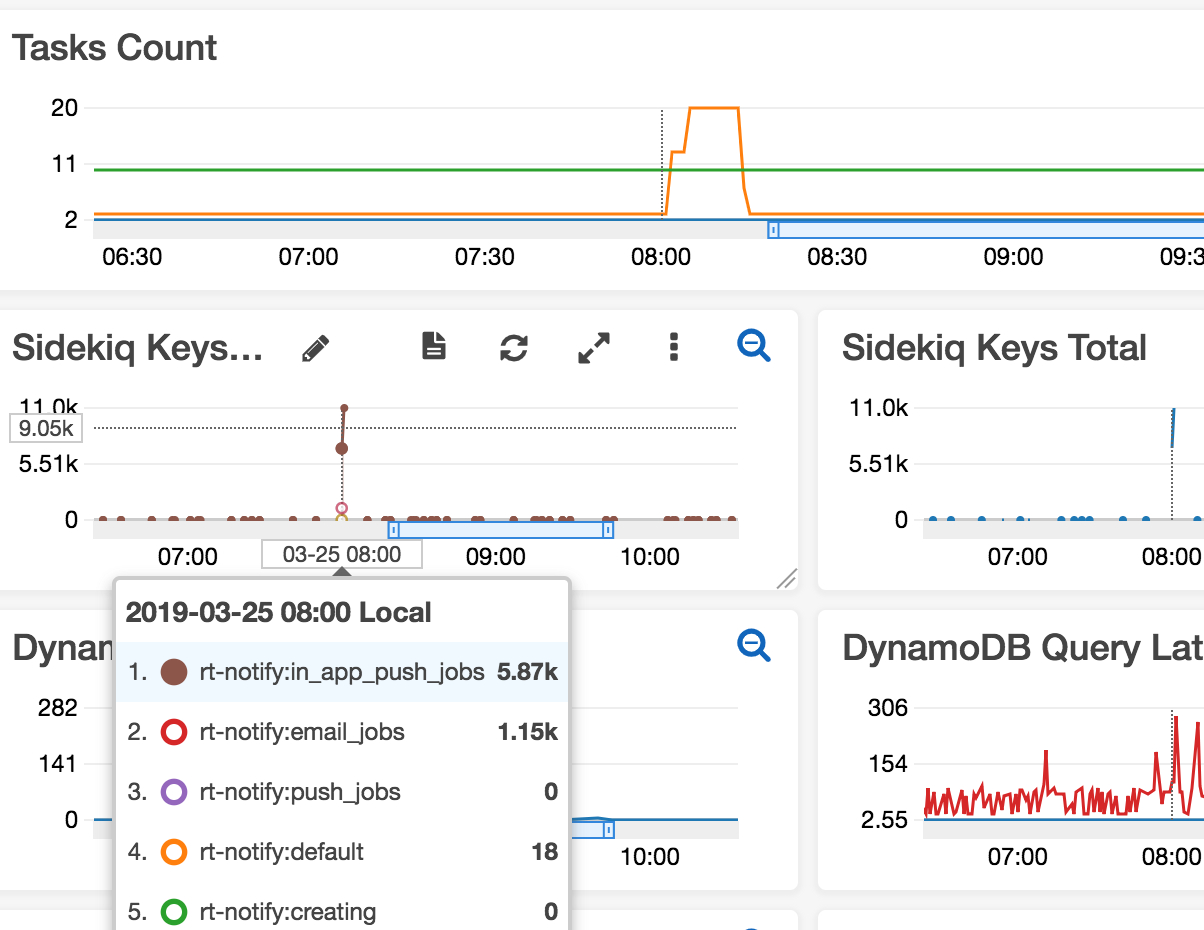
如果你的服务器一下子来了很多任务 你都希望尽快完成,那你就需要考虑 auto scaling,我们有个定时任务 定时去 redis 里查 有多少个 key,如果某个 queue 里的 key 增加到一定数量就会触发 增加服务器,启动更多的 sidekiq 进程。Task Count 就是服务器数量,key 少了就减少服务器。自动扩展需要考虑数据库 max connection,设置个服务器上限和下限。

对 yakjuly 回复

为啥不用多线程做?ruby 多线程不靠谱吗?

对 yfractal 回复

可以用 sidekiq thread,thread 多了,任务满载,cpu 和 memory 容易 100%。 进程也是一样的,不过你可以在不同的服务器上开进程,不用把所有资源都放在一个服务器上,自己控制 threads,把 cpu,memory 控制在合理范围内就好。

这种要自己定义规则了吧,感觉数据库最适合,再加一个 worker 去数据库定期取数据放在 queue 里

不要把分析 N 个公司作为一次原子操作,

建议把分析一个公司,变为一次原子操作

用那种加权方式 比如 A 客户等级是 100 B 客户等级是 10 , 之后 A 客户的一个企业分析权值就是 100, B 的一个企业分析一次分析就是 10

之后一个 true 循环这个大数组,每循环一次,数组里所有权值 + 1 , 之后再把权值最大的任务执行掉,拿出去。

这里的重点,是每检测循环一次,数组所有的权值 +1

这样,具有最高权值的任务就会优先执行,低权值的数据,也会因为遍历次数的增长,而变成高权值的数据,不至于在这个循环里没有执行的机会

对 yakjuly 回复

明白,看来八成是 cpu 密集型任务,多线程没啥意义。亦或是 sidkiq 调度多任务的时候,消耗比较大……

对 nouse 回复

这个定期取数据的 worker 是独立的是吧?启动 server 以后就开启这个 worker, 比如 每 10 秒观察 Redis 数据库里的这个特别 queue. 看到有就启动我们的别的 worker.perform_async ?

对 nouse 回复

你好,这里放在数据库里定期去取,这里哪种数据库比较好,是 PG 还是 Redis? 我看到 Redis 好难操作啊,不知道如何存储

需要 登录 后方可回复, 如果你还没有账号请 注册新账号